 Robert Niechciał
Znaczniki HTML dla SEO opisują temat i strukturę strony oraz przekazują wyszukiwarce reguły indeksowania, czyli umieszczania treści w wynikach. Optymalizacja obejmuje tytuł, nagłówki, opisy obrazów i ustawienia techniczne. Zacznij od sprawdzenia, czy strona przeznaczona do publikacji pozwala Google odczytać treść i wskazuje właściwy adres główny.
Czym są znaczniki HTML i gdzie ich szukać?
Na stronie, którą edytujesz, znaczniki HTML wyznaczają elementy dokumentu, a ich atrybuty dodają informacje, np. adres linku. HTML, czyli HyperText Markup Language, jest językiem opisu zawartości strony. Znacznik podwójny ma otwarcie i zamknięcie, np. <p>Opis produktu</p>. Znacznik pojedynczy, taki jak <img>, występuje bez osobnego zamknięcia.
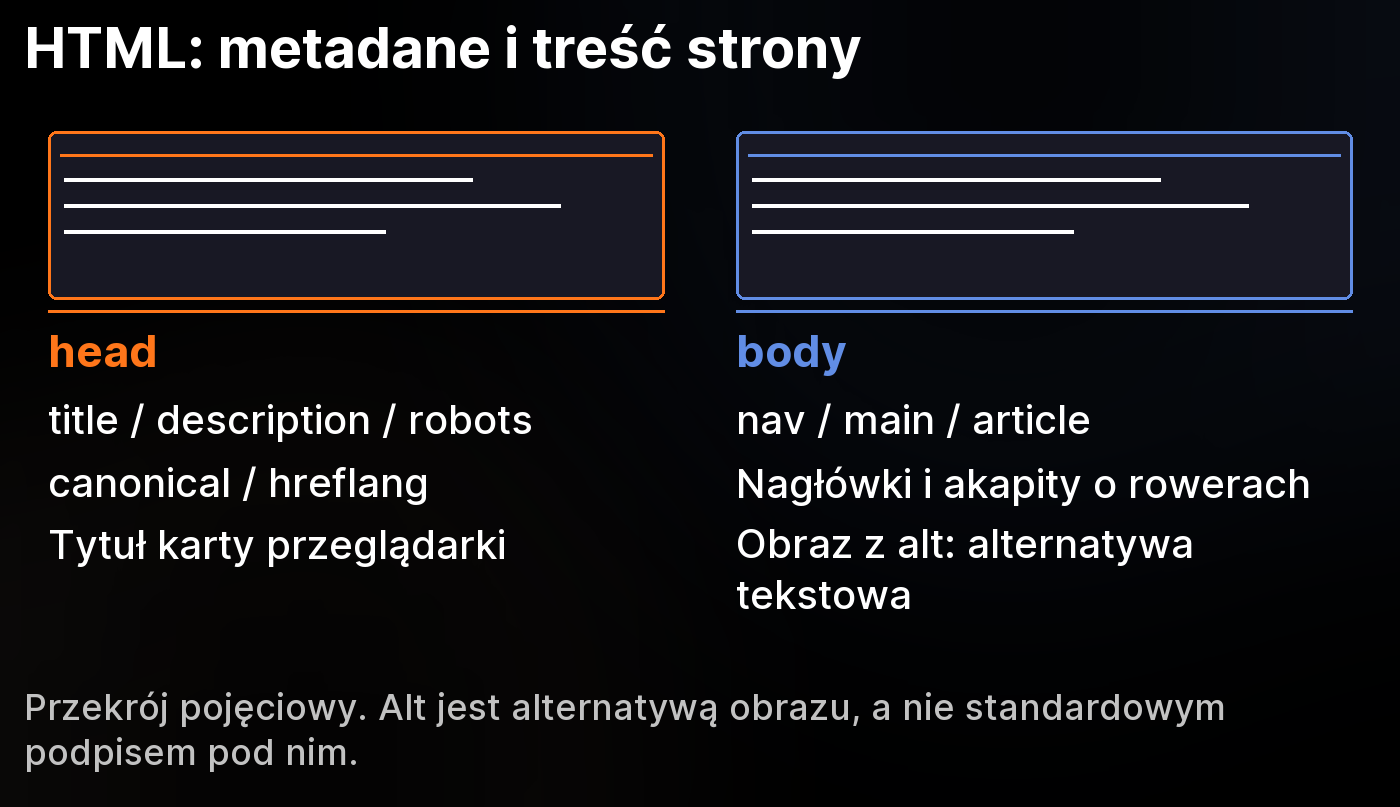
Dokument HTML5 zaczyna deklaracja <!DOCTYPE html>. Wewnątrz elementu <html> są 2 główne części:
| Część dokumentu | Co zawiera | Co sprawdzisz |
|---|---|---|
<head> |
Tytuł, meta tagi i odnośniki do zasobów | Ustawienia dla wyszukiwarki i przeglądarki |
<body> |
Widoczną treść, obrazy i nawigację | Zawartość dostępną czytelnikowi |
Atrybut HTML stoi w znaczniku otwierającym. Sprawdź podstawowe ustawienia dokumentu:
lang="pl": zapis na elemencie<html>określa język dla przeglądarki i narzędzi dostępności.<meta charset="UTF-8">: znacznik ustala kodowanie polskich liter.- Viewport: ustawienie steruje skalowaniem widoku mobilnego.
Oddzielenie metadanych od treści pomaga wskazać miejsce poprawki osobie zarządzającej stroną.
Jak znaczniki semantyczne porządkują treść strony?
Gdy czytelnik szuka konkretnej informacji, znaczniki semantyczne HTML pomagają rozpoznać części strony według ich funkcji:
<main>: obejmuje główną treść.<nav>: obejmuje nawigację.<article>: oznacza samodzielną publikację.<header>i<footer>: oznaczają wprowadzenie oraz stopkę strony lub jej części.<section>: grupuje tematyczną sekcję.<aside>: oznacza treść poboczną.
Znaczniki niesemantyczne HTML, czyli <div> i <span>, grupują zawartość bez takiego opisu roli. Atrybut class umożliwia przypisanie im stylów. Zamiana wszystkich bloków na elementy semantyczne nie daje automatycznego wzrostu pozycji. Dobór znacznika wynika z funkcji treści i ułatwia nawigację także osobom korzystającym z czytników ekranu.
W treści dobierz elementy do rodzaju informacji:
- Akapit: element
<p>. - Lista:
<ul>bez numeracji albo<ol>z numeracją oraz<li>dla każdej pozycji. - Porównanie danych:
<table>z wierszami<tr>, komórkami<td>i nagłówkami<th>. Podpis<caption>stoi po otwarciu tabeli. - Wyróżnienie:
<strong>oznacza ważność, a<em>akcent wypowiedzi.
Taki zapis zachowuje znaczenie treści także po wyłączeniu stylów.
Jak ustawić hierarchię nagłówków H1-H6?
Dla czytelnika skanującego ofertę nagłówki HTML H1-H6 tworzą plan treści: H1 opisuje temat strony, H2 główne sekcje, a H3 ich podsekcje. Kolejne poziomy służą dalszym podziałom. Wielkość liter i wygląd nagłówka określają style, więc sam duży napis nie potwierdza obecności H1.
Przykładowa hierarchia dla kategorii produktów wygląda tak:
<h1>Rowery miejskie</h1>
<h2>Jak dobrać rozmiar roweru?</h2>
<h3>Jak zmierzyć wysokość ramy?</h3>
<h2>Jakie wyposażenie wybrać?</h2>
Jeden nagłówek H1 jest czytelnym punktem wyjścia dla szablonu strony. Google nie określa idealnej liczby nagłówków ani obowiązkowej kolejności na potrzeby rankingu. Zachowanie poziomów ułatwia jednak orientację czytelnikom i nawigację czytnikom ekranu. Pominięcie poziomu nie oznacza automatycznej kary SEO.
Sprawdź, czy menu, logo lub powtarzany baner nie zajmują miejsca tytułu publikacji w hierarchii. Nazwa każdej sekcji opisuje jej własną zawartość. Nagłówki stają się wtedy użytecznym spisem zagadnień, także poza wizualnym układem strony.
Jak napisać title i meta description?
Gdy wynik wyszukiwania słabo opisuje Twoją ofertę, zacznij od title i meta description zgodnych z treścią podstrony. Element <title> określa tytuł dokumentu, widoczny m.in. na karcie przeglądarki. Nazwa „meta title” jest potoczna, ponieważ title jest osobnym elementem. Znacznik <meta name="description"> przekazuje proponowany opis wyniku.
<title>Rowery miejskie z niską ramą | Przykładowy sklep</title>
<meta name="description" content="Rowery miejskie z niską ramą. Porównaj rozmiary ram, wyposażenie i dostępne modele.">
Zacznij tytuł od tematu strony i dopisz wyróżnik zgodny z ofertą. Każda istotna podstrona dostaje własny tytuł i opis. Przy dużym katalogu rozpocznij redakcję od stron ofertowych i kategorii, które już zbierają wyświetlenia. W WordPressie pola te udostępniają wtyczki, np. Yoast SEO. Po zapisaniu sprawdź wynikowy kod strony.
Google Search Central w wytycznych tytułów nie wyznacza limitu znaków title. Około 60 znaków może służyć jako roboczy budżet redakcyjny, ale długość wyświetlanego wyniku zależy od jego szerokości. Link tytułowy Google powstaje również na podstawie nagłówków i tekstu strony.
W dokumentacji opisów Google wyjaśnia też, że może zastąpić meta description fragmentem treści dopasowanym do zapytania. Opis pomaga podjąć decyzję o kliknięciu, a sam w sobie nie jest czynnikiem rankingowym.
Jak meta robots steruje indeksowaniem strony?
Dla podstrony znikającej z wyników meta robots jest jednym z pierwszych ustawień do sprawdzenia: dyrektywa noindex wyklucza stronę z indeksu po odczytaniu jej przez Google. Zapis <meta name="robots" content="noindex"> umieszcza się w sekcji <head>. Nazwa robots obejmuje obsługujące ją roboty, a googlebot zawęża regułę do robota Google.
| Dyrektywa | Znaczenie dla Google |
|---|---|
index, follow lub all |
Domyślny brak ograniczeń indeksowania i korzystania z linków |
noindex |
Wykluczenie strony z wyników |
nofollow |
Prośba o niekorzystanie z linków na stronie, traktowana jako wskazówka |
none |
Połączenie noindex, nofollow |
nosnippet |
Wyłączenie fragmentu tekstowego wyniku |
noimageindex |
Ograniczenie indeksowania obrazów z danej strony |
Nagłówek odpowiedzi serwera X-Robots-Tag pozwala przekazać reguły także dla pliku PDF. Przy sprzecznych regułach robots Google stosuje bardziej restrykcyjne ograniczenie. Wartość index nie usuwa więc równoległego noindex.
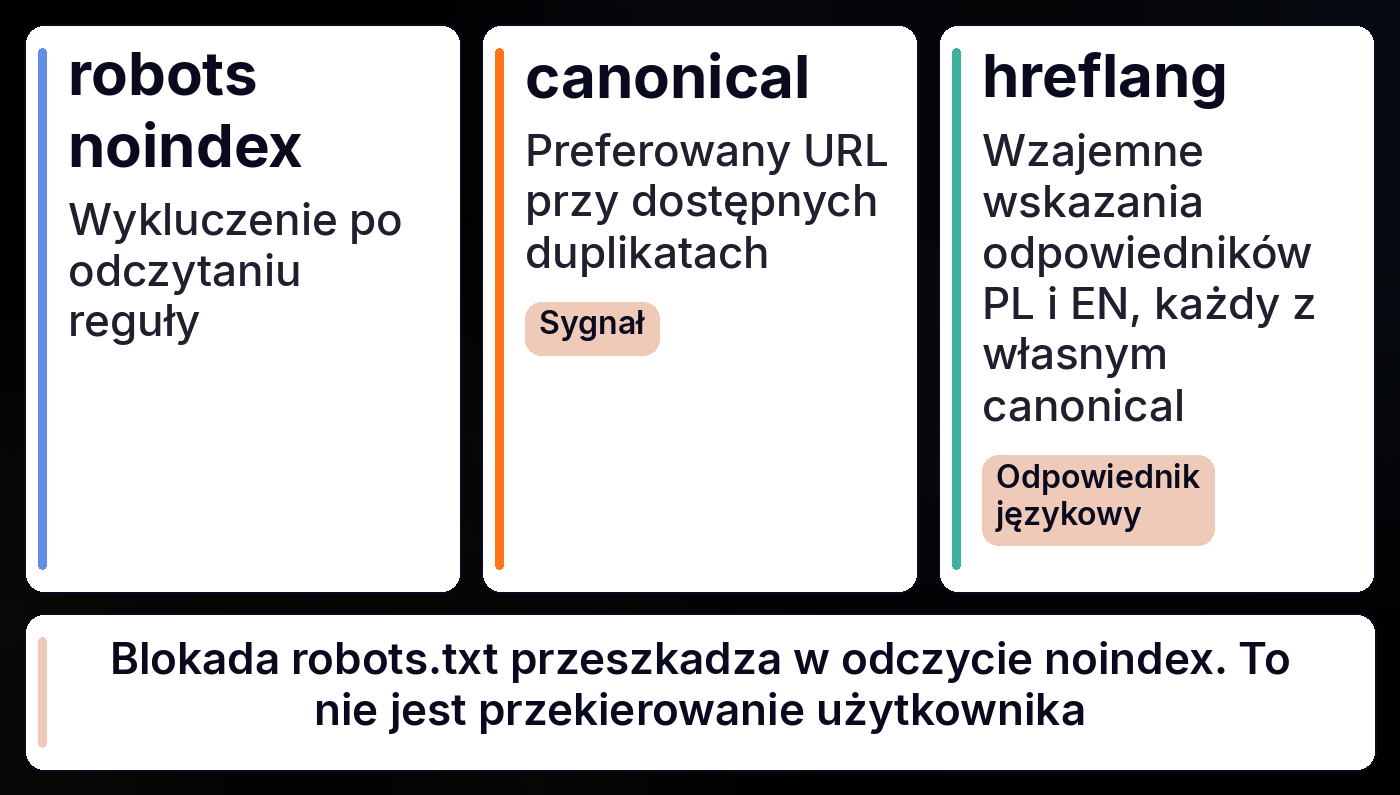
Google odczyta regułę dopiero po pobraniu strony. Blokada w pliku robots.txt może uniemożliwić zobaczenie noindex, a sam adres nadal pojawić się w wynikach. Dla stron przeznaczonych do usunięcia zastosowanie tych mechanizmów opisuje instrukcja wycofania adresu z Google. Rozdzielenie blokady pobierania od wykluczenia z wyników zapobiega sprzecznym wdrożeniom.
Jak canonical wskazuje główny adres strony?
Przy kilku adresach tej samej karty produktu tag canonical wskazuje Google preferowaną wersję, czyli stronę kanoniczną. Zapis rel="canonical" umieszcza się w elemencie <link> w sekcji <head>. Atrybut href zawiera pełny adres wraz z protokołem i domeną.
<link rel="canonical" href="https://example.com/rowery/miejskie/">Strona kanoniczna może wskazywać samą siebie, a jej duplikaty ten sam główny adres. Wybierz adres dostępny, z treścią odpowiadającą duplikatom i przeznaczony do indeksowania. Potwierdź go także w linkach wewnętrznych oraz mapie witryny. Canonical jest sygnałem wyboru wersji, dlatego Google może wybrać inną stronę na podstawie pozostałych sygnałów.
Dokumentacja kanonizacji Google klasyfikuje canonical i przekierowanie jako silne sygnały, a URL w mapie witryny jako słaby. Przekierowanie dodatkowo przenosi użytkownika na inny adres. Canonical pozostawia obie strony dostępne, co ma zastosowanie np. przy wariantach adresów potrzebnych w serwisie. Reguła noindex służy do wykluczania stron, więc wybór wersji głównej oprzyj na sygnałach kanonicznych.
Jak oznaczyć wersje językowe przez hreflang?
Gdy firma publikuje odpowiedniki strony w kilku językach, hreflang pomaga Google dobrać właściwy wariant do odbiorcy. Atrybut opisuje relację między wersjami językowymi lub regionalnymi. Każda wersja wskazuje siebie i pozostałe odpowiedniki, a adresy zawierają protokół oraz domenę.
<link rel="alternate" hreflang="pl" href="https://example.com/pl/rowery/">
<link rel="alternate" hreflang="en" href="https://example.com/en/bikes/">
<link rel="alternate" hreflang="x-default" href="https://example.com/en/bikes/">
Ten sam zestaw trafia do sekcji <head> obu wersji. Kod języka, np. pl, można uzupełnić o region, np. en-US. Wartość x-default wskazuje stronę dla użytkowników spoza wymienionych wariantów. Oznaczenia działają również przez nagłówki HTTP lub mapę witryny, więc wybierz metodę możliwą do utrzymania przez Twój zespół.
Wersje polska i angielska zachowują własne adresy kanoniczne. Ustawienie canonical obu wersji na stronę polską podważa ich odrębność. Sprawdź wzajemne wskazania po dodaniu tłumaczenia i po zmianie adresu. Rozszerzony opis wdrożenia hreflang pomaga skontrolować spójność całego zestawu.
Jak opisać obrazy atrybutem alt?
Dla osoby korzystającej z czytnika ekranu atrybut alt zastępuje informację przekazywaną przez obraz, a wyszukiwarce dostarcza kontekstu grafiki. Opis dobieraj do funkcji ilustracji na konkretnej stronie. Zdjęcie produktu opisuje cechy widocznego modelu, a wykres wymaga także tekstowego wyjaśnienia danych w treści.
<img src="rower-miejski.jpg" alt="Rower miejski z niską ramą i przednim koszykiem" width="800" height="600">Atrybut src wskazuje plik. Atrybuty width i height określają wymiary obrazu, co pomaga przeglądarce zarezerwować miejsce.
Dla czysto dekoracyjnego obrazka użyj alt="". Pusty alt jest wtedy świadomą decyzją dostępnościową. Przy obrazie będącym linkiem opis wskazuje cel przejścia, np. stronę główną sklepu w przypadku logo.
Google interpretuje grafiki z użyciem opisu alternatywnego, analizy obrazu oraz otaczającej treści. Nazwa pliku obrazu daje dodatkową wskazówkę tematu. Fraza pasuje do alt wtedy, gdy opisuje widoczną zawartość. Przy kontroli obrazów sprawdź osobno brak atrybutu i pustą wartość, żeby nie dopisywać opisów dekoracjom. Priorytet mają zdjęcia produktów oraz grafiki niosące informację potrzebną do decyzji zakupowej.
Jak zapisywać linki wewnętrzne w HTML?
Dla czytelnika przechodzącego z poradnika do produktu element <a> z atrybutem href tworzy odnośnik do strony docelowej. Tekst kotwicy, czyli widoczna etykieta linku, opisuje cel przejścia. „Rowery miejskie z koszykiem” mówi o zawartości dokładniej niż „więcej”.
Atrybut id nadaje elementowi identyfikator, do którego może prowadzić link z fragmentem adresu. Identyfikatory są przydatne w spisach treści, dlatego zachowaj je także po zmianie brzmienia nagłówków. Dla odnośników do innych podstron używaj aktualnych adresów końcowych. Link przez przekierowanie zwiększa liczbę przejść potrzebnych do pobrania celu.
Wartość nofollow w atrybucie rel dotyczy konkretnego odnośnika. Meta robots z tą samą wartością obejmuje linki na całej stronie. Te ustawienia mają inny zakres, dlatego odrębnie sprawdź kod linku i reguły dokumentu. Przy nawigacji pokazującej położenie produktu w kategoriach okruszki nawigacyjne pomagają uporządkować drogę do nadrzędnych stron.
Jak kod HTML wpływa na szybkość ładowania?
Dla odwiedzającego czekającego na ofertę kod HTML ma znaczenie przez rozmiar dokumentu, liczbę elementów i sposób dołączania zasobów. Czysty HTML może ograniczyć pracę przeglądarki, ale samo skrócenie kodu nie wyjaśnia opóźnień zdjęć, serwera ani skryptów.
Style CSS, czyli reguły wyglądu strony, można dołączać elementem <link rel="stylesheet" href="styles.css"> albo umieszczać wewnątrz <style>. JavaScript, język obsługujący interakcje, może zmieniać dokument po pobraniu. Zbyt rozbudowana struktura i zasoby blokujące wyświetlenie treści wymagają pomiaru przed wyborem poprawki. Usuwanie białych znaków zmniejsza plik HTML, lecz nie zastępuje analizy zasobów.
Sprawdź szybkość strony przed wdrożeniem i po nim w porównywalnych warunkach. Raport PageSpeed Insights wskaże problemy wydajności oraz dostępne dane od rzeczywistych użytkowników. Zapisz adres, datę i warunki testu, żeby porównywać tę samą podstronę. Wybieraj poprawki odpowiadające zmierzonemu opóźnieniu, zamiast usuwać znaczniki potrzebne do zrozumienia treści.
Jak sprawdzić błędy HTML po zmianie szablonu?
Po aktualizacji strony błędy HTML sprawdzisz przez porównanie kodu pobranego z serwera, dokumentu widocznego w przeglądarce i danych od Google. Audyt SEO obejmuje też relacje między adresami, więc kontrola jednej karty produktu jest początkiem sprawdzenia szablonu.
Przeglądarka Chrome udostępnia „Wyświetl źródło strony” dla kodu odpowiedzi oraz „Zbadaj” dla bieżącego dokumentu. Narzędzia deweloperskie, w tym konsola deweloperska, pozwalają analizować zmiany po wykonaniu JavaScript. DOM to reprezentacja dokumentu, którą przeglądarka buduje i modyfikuje. Różnice między źródłem a DOM wymagają kontroli renderowania strony, czyli przetwarzania kodu w widok i strukturę dokumentu.
| Kontrola | Sygnał problemu | Potwierdzenie poprawki |
|---|---|---|
| Title i description | Dodatkowy lub pusty element po aktualizacji | Jedna właściwa wartość w wynikowym HTML |
| Robots | Nieplanowane noindex w kodzie lub odpowiedzi serwera |
Brak blokady dla publikowanej strony |
| Canonical | Inny produkt albo adres z przekierowaniem | Docelowy adres i wybór Google w kontroli URL |
| Struktura dokumentu | Treść lub obraz w <head> |
Poprawne umiejscowienie metadanych |
Walidator W3C pomaga wykryć błędy składni. W Google Search Console użyj Sprawdzenia adresu URL (URL Inspection), żeby porównać wersję z indeksu z testem aktualnej strony. Odróżnij datę ostatniego pobrania od momentu wdrożenia. Wynik kontroli kodu jest od razu dostępny, a zmiana w indeksie zależy od ponownego przetworzenia strony przez Google.
Od czego zacząć optymalizację znaczników na swojej stronie?
Dziś wybierz jedną stronę ofertową lub kategorię i wykonaj kontrolę:
- Sprawdź title, robots i canonical w źródle oraz nagłówki w widocznej treści. Zapisz stan przed poprawką.
- Wprowadź zmianę w systemie zarządzania treścią. Ponownie sprawdź wynikowy HTML, aby potwierdzić wdrożenie.
- Przy znacznikach Open Graph skontroluj osobno podgląd udostępnienia w mediach społecznościowych.
Google pomija meta keywords, więc uzupełnianie listy fraz w tym polu nie jest zadaniem optymalizacyjnym.
Samodzielnie zmienisz tytuł lub opis w dostępnym polu edytora. Dodatkowe elementy generowane przez szablon, sprzeczne reguły i błędy powtarzane na adresach produktów wymagają pracy programisty. Sprawdź próbkę każdej zmienionej odmiany szablonu przed publikacją całego katalogu.
Gdy problem obejmuje indeksowanie, duplikaty lub wydajność całego serwisu, techniczne SEO daje Ci diagnozę, rekomendacje i wsparcie zespołu deweloperskiego przy pracy nad poprawkami.