 Robert Niechciał
Crawler, czyli robot internetowy, to program, który automatycznie odwiedza strony internetowe, odkrywa linki i zbiera dane o treści oraz strukturze witryny. Wyszukiwarki wykorzystują crawlery do pozyskiwania materiału do indeksu, czyli zbioru stron rozpatrywanych przy wyszukiwaniu. Specjaliści SEO, zajmujący się widocznością w bezpłatnych wynikach wyszukiwania, używają ich do wykrywania błędów technicznych.
Gdy nowe produkty nie pojawiają się w Google albo po przebudowie znikają strony oferty, zleć osobie odpowiedzialnej za SEO sprawdzenie ich dostępności dla robota. W serwisie usługowym podobnym sygnałem jest utrata widoczności podstron pozyskujących zapytania po migracji, czyli przeniesieniu strony na nową domenę lub platformę.
Co oznacza crawler po polsku?
Crawler po polsku to robot sieciowy, robot internetowy lub pająk, od angielskiego „to crawl”, czyli pełzać lub czołgać się. W kontekście wyszukiwarek spotkasz też nazwę „robot indeksujący”. Określenie opisuje rolę robota w wyszukiwarce, choć pobieranie stron i budowa indeksu są oddzielnymi etapami.
Crawling, czyli skanowanie, oznacza automatyczne przeszukiwanie zasobów. Crawler może zebrać kod HTML, czyli zapis treści i struktury strony, adresy odnośników i informacje o odpowiedzi serwera. Zakres analizy zależy od konfiguracji programu i celu skanowania.
Crawler różni się od scrapera, który wyodrębnia konkretne dane z dokumentu, na przykład ceny i parametry produktów. Robot może odkryć adresy kart produktów, a scraper odczytać z nich wskazane pola. Jeden program może łączyć obie funkcje. Przy wyborze oprogramowania rozdziel więc potrzebę znalezienia stron od potrzeby zebrania danych z ich zawartości.
Jak działa crawler i skąd bierze adresy stron?
Crawler pobiera adresy z kolejki, odczytuje linki na stronie i dodaje odkryte adresy do dalszego skanowania. Po publikacji strony zapewnij robotowi drogę do niej przez link lub mapę strony.
Pierwszym punktem skanowania może być wskazana podstrona, strona główna lub lista adresów ze wcześniejszych odwiedzin. Mapa strony (sitemap), nazywana też mapą witryny XML, to przygotowana przez właściciela lista adresów dla robotów, w tym Googlebota, czyli robota wyszukiwarki Google.
Przebieg skanowania obejmuje następujące kroki:
- Robot wybiera adres strony (URL) z kolejki i sprawdza reguły dostępu z pliku robots.txt, czyli instrukcji skanowania dla robotów.
- Robot pobiera zasób, otrzymując kod odpowiedzi serwera i jego zawartość.
- Robot analizuje dokument, w tym linki wewnętrzne oraz odnośniki do innych serwisów.
- Robot dodaje znalezione adresy do dalszej analizy i aktualizuje informacje o odwiedzonym zasobie.
Kolejka skanowania porządkuje adresy oczekujące na wizytę. O priorytecie pobrania decydują między innymi popularność strony, częstotliwość aktualizacji i kondycja techniczna serwera. Googlebot wraca do znanych stron, aby wykrywać zmiany treści i linków. Termin odwiedzin zależy od tych czynników i dostępnych zasobów wyszukiwarki.
Czym skanowanie różni się od renderowania i indeksowania?
Skanowanie pobiera zasoby, renderowanie odtwarza zawartość strony, a indeksowanie przetwarza informacje na potrzeby wyszukiwania. Rozdzielenie tych etapów pomaga ustalić, dlaczego strona działa w przeglądarce, lecz pozostaje poza wynikami Google. Google opisuje te zależności w dokumentacji działania wyszukiwarki. Odpowiedź serwera 200 oznacza udane pobranie zasobu. Stan indeksowania sprawdza się osobno.
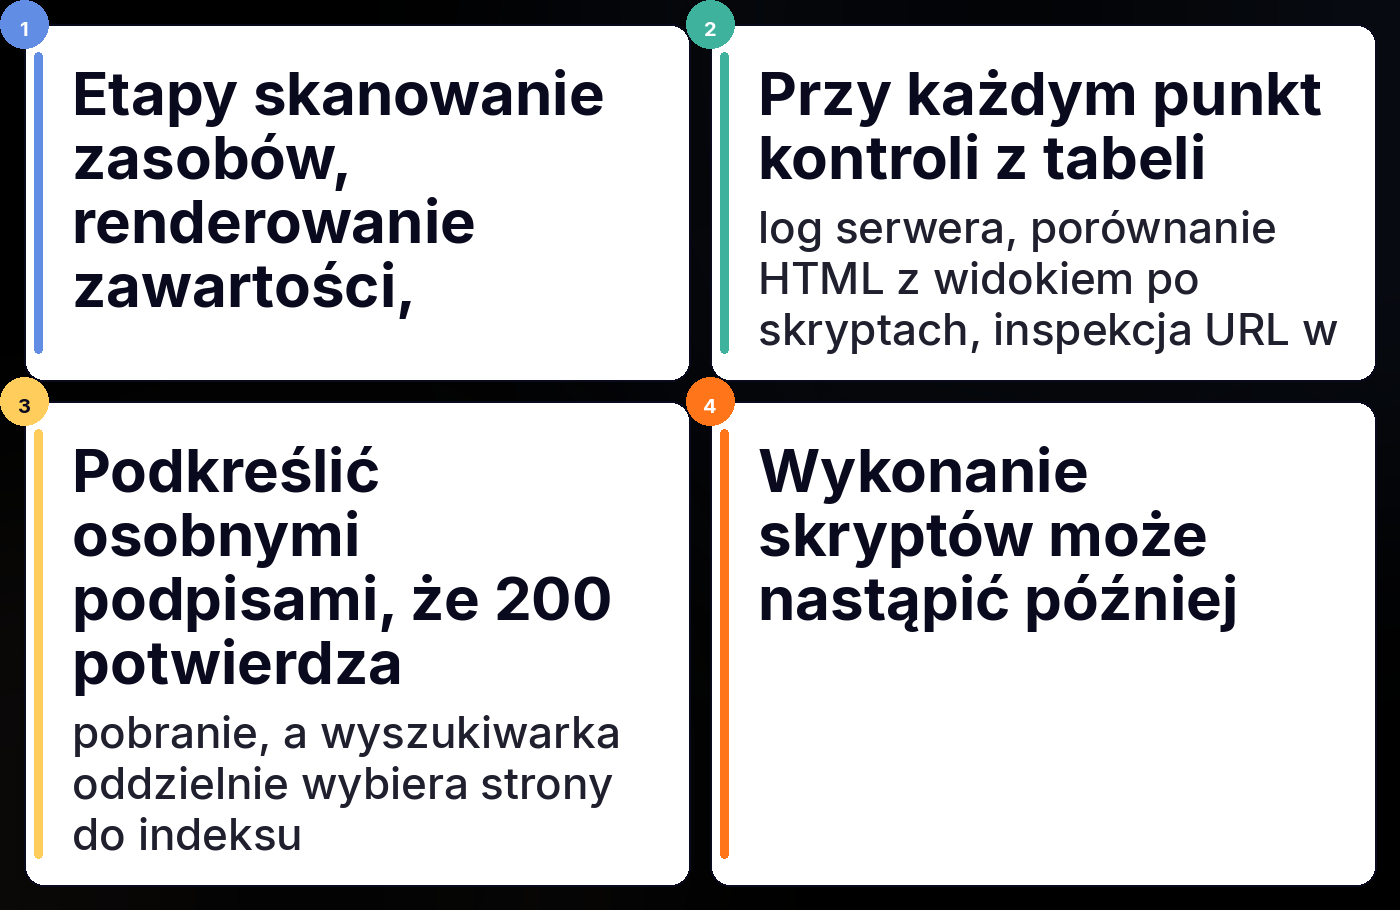
| Etap | Co dzieje się ze stroną? | Jak sprawdzić wynik? |
|---|---|---|
| Skanowanie | Robot pobiera dokument lub inny zasób. | Log serwera, czyli rejestr wizyt, pokazuje żądanie i status HTTP, czyli kod odpowiedzi. |
| Renderowanie | Przeglądarka wykonuje skrypty strony (JavaScript) i tworzy wynikową zawartość. | Porównanie HTML z widokiem po wykonaniu skryptów ujawnia brakujące elementy. |
| Indeksowanie | Wyszukiwarka analizuje treść i wybiera strony do indeksu. | Inspekcja adresu w Google Search Console, narzędziu do kontroli obecności strony w Google, pokazuje stan indeksowania. |
Googlebot wykonuje skrypty w przeglądarce działającej automatycznie, bez okna obsługiwanego przez człowieka. Pobranie HTML i wykonanie skryptów mogą odbyć się w różnym czasie. Zablokowane skrypty utrudniają odczyt treści.
Instrukcja noindex oznacza wykluczenie strony z indeksu i działa po odczytaniu przez robota. Blokada pobierania w robots.txt uniemożliwia jej odczyt, a zablokowany adres może nadal pojawić się w wynikach dzięki linkom z innych stron. Z kolei canonical wskazuje adres kanoniczny, czyli preferowaną wersję dokumentu, jako sugestię dla wyszukiwarki. Wykrywanie różnic między kodem a gotowym widokiem opisuje wpis o renderowaniu stron.
Jakie są typy crawlerów i do czego służą?
Crawlery mogą obsługiwać wyszukiwarkę, audyt techniczny, archiwum albo monitoring zmian. Dobierz robota do pytania, na które szukasz odpowiedzi. Pełne skanowanie obejmuje analizę całej witryny, a skanowanie odświeżające służy sprawdzaniu zmian w jej zawartości. Zakres analizy ustal przed uruchomieniem programu.
| Zastosowanie | Zakres pracy crawlera | Przykład wykorzystania danych |
|---|---|---|
| Wyszukiwarka | Pobieranie treści i odkrywanie adresów. | Googlebot dostarcza zasoby do przetwarzania przez Google. |
| Audyt SEO | Analiza całej witryny albo wybranego fragmentu. | Wykrycie uszkodzonych linków w katalogu produktów. |
| Archiwizacja | Zbieranie kopii dostępnych dokumentów. | Internet Archive przechowuje historyczne wersje stron. |
| Monitoring | Ponowne skanowanie ustalonego zestawu adresów. | Porównanie opisów produktów przed zmianą i po niej. |
Crawlery AI, czyli roboty systemów sztucznej inteligencji, pełnią różne funkcje. GPTBot i ClaudeBot zbierają treści na potrzeby rozwoju modeli. Roboty wyszukiwania pobierają materiał do odpowiedzi na zapytania. Operatorzy opisują przeznaczenie poszczególnych botów i reguły dostępu. Zgody na trening i wyszukiwanie rozpatruj oddzielnie dla każdego robota.
Dlaczego crawlery są ważne dla SEO?
Crawler SEO pomaga wykryć błędy techniczne utrudniające robotom wyszukiwarek dostęp do kategorii i produktów. Brak linku wewnętrznego i pusty dokument wymagają różnych napraw. Przekierowanie odsyła robota do innego adresu, a zapętlone przekierowania prowadzą go z powrotem do wcześniej odwiedzonego zasobu.
Przykład diagnostyczny: karta produktu zwraca 200, ale prowadzący do niej odnośnik wskazuje adres ze statusem 404, czyli informacją o braku strony. Produkt pozostaje dostępny pod poprawnym adresem, jednak ścieżka dojścia z kategorii jest przerwana. Poprawienie adresu w odnośniku przywraca drogę z kategorii do produktu.
Zestawienie skanu z listą docelowych stron ujawnia też zasoby pominięte w analizie. Administrator sprawdza wtedy, czy brak wynika z niedostępnego linku, blokady dostępu czy konfiguracji skanu. Tak ustalona przyczyna wyznacza zadanie dla zespołu. Usunięcie przeszkody ułatwia robotom dostęp do treści, a ocena pozycji w wynikach wymaga także analizy treści i konkurencji.
Jak wykorzystać crawler do analizy konkurencji?
Crawler pozwala porównać publiczną strukturę i treści serwisu konkurenta oraz wykryć zmiany między skanami. Przy rozbudowie oferty konkurenta zapis zmian pokazuje, jakie tematy i produkty udostępnia on odbiorcom. Zakres skanu ograniczają zasady dostępu i prawo.
Analiza może obejmować:
- Kategorie produktów.
- Tematy publikacji.
- Tytuły stron.
- Powiązania między podstronami.
Porównaj liczbę adresów w wybranej kategorii między zapisanymi skanami i sprawdź, które podstrony dodano lub usunięto. Zanotuj daty obu skanów i zachowaj ten sam zakres porównania.
Przykładowo nowa kategoria w menu daje podstawę do sprawdzenia jej zakresu i sposobu opisania produktów. Sprawdź, czy Twoja oferta obejmuje podobne potrzeby odbiorców i czy opisuje je na dostępnych podstronach. Zapis skanu daje zespołowi adresy do takiego porównania.
Jak crawler wykorzystuje crawl budget?
Crawl budget, czyli budżet skanowania, to liczba adresów, które Googlebot może i chce pobrać w określonym czasie. Wydajność serwera i dostępne zasoby obliczeniowe wpływają na tę liczbę. Przy rozbudowanym sklepie z filtrami sprawdź, jakie adresy robot pobiera. Google wiąże budżet z limitem wydajności i zapotrzebowaniem na skanowanie w dokumentacji crawl budget.
Dwa pojęcia opisują różne aspekty skanowania:
| Pojęcie | Znaczenie |
|---|---|
| Crawl rate, czyli tempo skanowania | Częstotliwość żądań |
| Crawl demand | Zapotrzebowanie na skanowanie |
Wolne odpowiedzi i błędy serwera mogą skłonić Googlebota do zmniejszenia częstotliwości pobierania.
W sklepie internetowym filtry i parametry mogą tworzyć liczne warianty adresów z podobną zawartością. Robot przeznacza wtedy zasoby na dokumenty, które nie wnoszą odrębnej treści. Pętle przekierowań dodatkowo utrudniają dotarcie do adresu docelowego.
Szczegółową analizę crawl budget zleć przy licznych wariantach adresów i opóźnieniach w pobieraniu nowych treści. W raporcie poproś o rozdzielenie wizyt na docelowych podstronach i wariantach tworzonych przez filtry, aby ocenić skalę problemu.
Jak optymalizować stronę dla crawlerów?
Optymalizacja strony dla crawlerów polega na zapewnieniu robotom dostępu do ważnych podstron przez sprawne linki, aktualną mapę strony i reguły robots.txt. Linkowanie wewnętrzne łączy dokumenty w strukturę serwisu, mapa pomaga odkrywać adresy, a plik robots.txt steruje dozwolonym skanowaniem.
Reguła Disallow zabrania pobierania wskazanej ścieżki, a Allow zezwala na jej pobranie. Zasady opisuje dokumentacja robots.txt Google. Wpływ blokady na obecność w wynikach wyjaśnia sekcja o etapach przetwarzania strony.
Przy kontroli witryny sprawdź:
- Czy strony kategorii linkują do docelowych produktów przez odnośniki dostępne w HTML?
- Czy mapa XML zawiera aktualne, kanoniczne adresy przeznaczone do indeksowania?
- Czy przekierowania prowadzą do działających stron bez pętli?
- Czy publiczne dokumenty i potrzebne zasoby są dostępne dla właściwego robota?
Każdą zmianę reguł dostępu sprawdź na konkretnym adresie. Porównaj zachowanie strony objętej regułą z działaniem strony, która ma pozostać dostępna dla robota.
Jak sprawdzić wizyty crawlera w logach serwera?
Logi serwera, czyli rejestr żądań, pokazują, kiedy robot odwiedził dany adres i jaką odpowiedź otrzymał. Przekaż administratorowi adresy, datę publikacji lub wdrożenia i okres, którego dotyczy problem. Poproś o potwierdzenie, czy Googlebot odwiedził wskazane strony po zmianie.
Administrator zestawia adresy, daty i odpowiedzi serwera oraz potwierdza źródło wizyt według instrukcji weryfikacji crawlerów Google. Sama deklarowana nazwa robota może być podrobiona. Od administratora otrzymasz potwierdzenie, czy wizyty pochodzą od prawdziwego Googlebota, oraz listę odwiedzonych stron po zmianie. Na tej podstawie odróżnisz brak wizyty od błędu odpowiedzi serwera i przekażesz zespołowi odpowiednie zadanie.
Przy adresach zwracających 404 sprawdź, czy dokument został celowo usunięty. Powroty robota mogą wynikać ze starych odnośników. Przekierowanie rozważ dla adresu, który ma odpowiadającą mu stronę zastępczą.
Jakie narzędzia służą do skanowania stron?
Do sprawdzenia błędnych linków, odpowiedzi serwera i duplikatów tytułów w sklepie użyj crawlera audytowego. Screaming Frog SEO Spider pozwala przeskanować wskazany zakres witryny i zebrać te błędy w raporcie. Wybór narzędzia zależy od wielkości serwisu, wymagań renderowania i danych potrzebnych do diagnozy. Crawler uruchomiony na komputerze korzysta z jego zasobów oraz dostępu do sieci.
Raport audytowy może obejmować następujące elementy:
- Kody odpowiedzi serwera, uszkodzone linki i przekierowania.
- Tytuły stron, główne nagłówki (H1) i meta tagi, czyli informacje o stronie zapisane w kodzie.
- Duplikację treści oraz strony z ubogą zawartością.
- Brakujące teksty alternatywne grafik i strukturę linkowania.
Przed skanem ustal adres startowy, zakres domen, czyli witryny objęte skanowaniem, oraz sposób obsługi JavaScriptu. Gdy raport wskazuje stronę z ubogą zawartością, sprawdź, czy odpowiada ona na pytanie odbiorcy. Zapisz brakujące informacje jako zadanie redakcyjne, jeśli temat wymaga rozwinięcia.
Jak bezpiecznie korzystać z crawlerów i raportować wyniki?
Bezpieczne korzystanie z crawlera wymaga uzgodnienia zakresu i tempa żądań z administratorem oraz zapisania wyników jako zadań z kryteriami odbioru. Takie przygotowanie pomaga kontrolować obciążenie serwera i ocenić wykonane naprawy. Skanowanie zacznij od próbki adresów, a wydajność obserwuj przed rozszerzeniem analizy.
Raport powiąż z zadaniami. Przy każdym problemie zapisz:
- Adres problemu.
- Objaw.
- Zalecaną zmianę.
- Osobę odpowiedzialną za wdrożenie oraz kontrolę wyniku.
- Sposób kontroli.
Oddziel błędy szablonu, czyli wspólnego układu stron kategorii, od błędów pojedynczych odnośników. Po wdrożeniu specjalista SEO ponawia skan tego samego zakresu i porównuje liczbę błędnych adresów. Powtarzaj taką kontrolę po kolejnych zmianach szablonów, aby wykrywać nawroty błędów.
Przykładowe kryterium do uzgodnienia z zespołem: zero odnośników do 404 w skanie kategorii i kart produktów po naprawie. Ustal termin ponownego skanu, zapisz daty kontroli przed wdrożeniem i po nim oraz zachowaj ten sam zakres. Zarządowi pokaż liczbę błędnych adresów przed naprawą i po niej, wraz z informacją, których produktów lub usług dotyczyły.
Jak crawlery wpływają na prywatność danych?
Crawler może pobrać dane osobowe lub dokumenty firmowe, jeśli są publicznie dostępne pod adresem witryny. Przed skanowaniem sprawdź z administratorem dostęp do takich plików. Prywatne zasoby wymagają uwierzytelniania (potwierdzenia tożsamości użytkownika) i kontroli uprawnień.
Dla przykładu plik z danymi klientów pozostaje osiągalny dla osoby znającej adres, nawet jeśli usuniesz odnośnik z menu. Ochrona polega na usunięciu publicznego dostępu albo objęciu zasobu sprawdzaniem uprawnień.
Gdy robot ignoruje robots.txt, przekaż administratorowi adresy i okres niepożądanych wizyt. Administrator zweryfikuje ich źródło w logach. Przy przekazywaniu zapisów do narzędzi ogranicz zakres danych, w tym adresy IP i parametry żądań, oraz sprawdź zasady przetwarzania.
Co zrobić w tym tygodniu, aby sprawdzić dostęp crawlera?
Sprawdź stan ważnych produktów, kategorii lub usług w Google Search Console. W małym serwisie zacznij samodzielnie od tej kontroli bez zamawiania płatnego skanu. Wydatek na szerszą analizę powiąż z konkretnym problemem: liczbą błędnych adresów, ich rolą w pozyskiwaniu zapytań lub sprzedaży i nakładem naprawy.
- Zapisz adresy ważnych produktów, kategorii lub usług. Wklej wybrany adres w pole inspekcji adresu URL u góry Google Search Console i zatwierdź. W wyniku inspekcji odczytaj informację, czy strona jest zindeksowana.
- Sprawdź wizyty robota według procedury z sekcji „Jak sprawdzić wizyty crawlera w logach serwera?”.
- Przełóż wykryte błędy na zadania według procedury z sekcji „Jak bezpiecznie korzystać z crawlerów i raportować wyniki?”.
Wsparcie specjalisty wybierz przy problemach obejmujących liczne szablony, serwer i indeksowanie albo przy braku danych do diagnozy. W ramach technicznego SEO otrzymasz od Vestigio rekomendacje oraz wsparcie Twojego zespołu deweloperskiego, aby przełożyć diagnozę na zadania wdrożeniowe. Zacznij od bezpłatnej 30-minutowej konsultacji online: ustalisz zakres potrzebnej współpracy i podstawę do indywidualnej wyceny.